
Sicherheitslücken CVE-2026-109618 & CVE-2026-109619 behoben
Kritische PHP-Sicherheitslücken: Qlik gibt Entwarnung Zwei kritische Sicherheitslücken in PHP...
TEILEN


Damit Erfahrung im Unternehmen bleibt
Wenn erfahrene Mitarbeitende das Unternehmen verlassen, geht häufig mehr verloren...
TEILEN
Mark Leifeld ist neuer Qlik Partner Ambassador
EVACO stellt auch 2026/2027 einen Qlik Partner Ambassador: Mark Philipp...
TEILEN
KI Usecase des Monats: Wie KI sensible Daten schützt
Cell Key - Wenn aggregiert nicht automatisch anonym bedeutet Ein...
TEILEN
 23. Oktober 2026
Sicherheitslücken CVE-2026-109618 & CVE-2026-109619 behoben
Kritische PHP-Sicherheitslücken: Qlik gibt Entwarnung
Zwei kritische Sicherheitslücken in PHP sorgen aktuell für Aufmerksamkeit. Qlik hat die betroffenen Komponenten seiner Cloud-Plattform bereits abgesichert und bestätigt, dass für Qlik-Kunden derzeit kein zusätzlicher Handlungsbedarf besteht. Wir fassen die wichtigsten Informationen und Empfehlungen zusammen.
Kritische Schwachstellen in PHP bekannt geworden
Am 21. Oktober 2026 wurden zwei kritische Sicherheitslücken in der weit verbreiteten Programmiersprache PHP veröffentlicht. Die Schwachstellen mit den Kennungen CVE-2026-109618 und CVE-2026-109619 können unter bestimmten Voraussetzungen die Einschleusung und Ausführung von Schadcode ermöglichen.
Da PHP in zahlreichen Webanwendungen und IT-Systemen eingesetzt wird, können die Sicherheitslücken ein erhebliches Risiko für betroffene Umgebungen darstellen.
Weitere technische Hintergründe zu den Schwachstellen liefert der aktuelle Sicherheitsbericht von Heise.
Qlik bestätigt: Qlik Cloud bereits abgesichert
Qlik hat schnell auf die bekannt gewordenen Schwachstellen reagiert und eine offizielle Sicherheitsmeldung veröffentlicht.
Die gute Nachricht: Die betroffenen Komponenten der Qlik Cloud Plattform wurden bereits aktualisiert und die Sicherheitslücken behoben. Nach Angaben von Qlik besteht damit keine Gefährdung durch die genannten Schwachstellen mehr.
Besonders wichtig für Unternehmen, die Qlik im täglichen Einsatz haben: Die Sicherheitslücken betrafen ausschließlich die Qlik Cloud Plattform. Andere Qlik-Produkte waren nach Angaben des Herstellers nicht betroffen.
Welche Qlik-Produkte sind betroffen?
Die wichtigsten Informationen im Überblick:
- Qlik Cloud: Die Plattform war von den PHP-Schwachstellen betroffen. Qlik hat die erforderlichen Sicherheitsmaßnahmen bereits umgesetzt und die Schwachstellen behoben.
- Qlik Sense Enterprise on Windows (Client-Managed): Nicht betroffen.
- QlikView: Nicht betroffen.
- Weitere Qlik On-Premise-Produkte: Nach Angaben von Qlik ebenfalls nicht betroffen.
Für Qlik-Kunden besteht im Zusammenhang mit diesen beiden Sicherheitslücken aktuell kein zusätzlicher Handlungsbedarf. Die erforderlichen Updates für die Qlik Cloud wurden zentral durch Qlik durchgeführt. Auch für die nicht betroffenen Qlik-Produkte sind keine zusätzlichen Sicherheitsupdates aufgrund dieser Schwachstellen erforderlich.
Was sollten Unternehmen jetzt beachten?
Auch wenn Qlik für seine Produkte Entwarnung gibt, sollten Unternehmen das Thema PHP-Sicherheit nicht grundsätzlich als abgeschlossen betrachten.
PHP kommt in vielen unterschiedlichen Anwendungen und Systemlandschaften zum Einsatz. Unabhängig von Qlik können deshalb weitere Anwendungen oder selbst betriebene Systeme von den Schwachstellen betroffen sein.
Wir empfehlen daher, die eigene IT-Infrastruktur auf mögliche betroffene PHP-Installationen zu überprüfen und verfügbare Sicherheitsupdates zeitnah einzuspielen.
Eine regelmäßige Überprüfung eingesetzter Softwarekomponenten und ein konsequentes Patch-Management bleiben wichtige Maßnahmen, um Sicherheitsrisiken frühzeitig zu erkennen und zu reduzieren.
Transparenz und Sicherheit bei Qlik
Mit der offiziellen Sicherheitsmeldung informiert Qlik transparent über die Auswirkungen der Schwachstellen auf die eigene Plattform und die bereits umgesetzten Maßnahmen.
Die Kommunikation erfolgt im Rahmen des Qlik Security Programms und der veröffentlichten Richtlinien zur Offenlegung von Sicherheitsinformationen.
Für Unternehmen, die Qlik Cloud oder Qlik On-Premise-Lösungen einsetzen, schafft diese transparente Kommunikation Klarheit über die eigene Betroffenheit und mögliche erforderliche Maßnahmen.
Die vollständige Stellungnahme des Qlik Security Teams findest Du hier:
Offizielle Qlik-Sicherheitsmeldung: Qlik Cloud Patched for PHP Vulnerabilities
EVACO unterstützt Dich bei Fragen zur Qlik-Sicherheit
Als Qlik-Partner verfolgen wir bei EVACO sicherheitsrelevante Entwicklungen kontinuierlich und informieren über wichtige Updates rund um die Qlik-Plattform.
Unser Ziel ist es, Dir eine verlässliche Grundlage für den sicheren Betrieb Deiner Business-Intelligence-Umgebung zu bieten.
Du hast Fragen zur Sicherheit Deiner Qlik-Umgebung oder möchtest mögliche Auswirkungen auf Deine BI-Infrastruktur besprechen?
Wir stehen Dir gerne beratend zur Seite.
Jetzt Kontakt zu EVACO aufnehmen

 TEILEN
23. Oktober 2026
Damit Erfahrung im Unternehmen bleibt
Wenn erfahrene Mitarbeitende das Unternehmen verlassen, geht häufig mehr verloren als eine besetzte Stelle: wertvolles Wissen über Prozesse, Entscheidungen und Ausnahmen. Mit unserer KI-gestützten Wissensplattform für Expertenwissen helfen wir Unternehmen, dieses Wissen systematisch zu erfassen, fachlich zu prüfen und dauerhaft im Arbeitsalltag nutzbar zu machen.
Expertenwissen sichern
Bis 2040 werden rund 13,3 Millionen Erwerbspersonen aus dem Jahr 2025 die Altersgrenze von 67 Jahren überschritten haben. Das entspricht 30 Prozent der damaligen Erwerbspersonen in Deutschland. Diese Zahlen des Statistischen Bundesamtes zeigen, wie groß die Herausforderung des demografischen Wandels für Unternehmen ist. [1]
Doch was bedeutet das für den Arbeitsalltag?
Welche Besonderheiten gelten beim Monatsabschluss? Warum wird ein bestimmter Prozess genau so ausgeführt? Und was ist zu tun, wenn ein Standardablauf nicht funktioniert?
Die Antworten auf solche Fragen kennen häufig nur erfahrene Kolleginnen und Kollegen. Vieles davon ist über Jahre gewachsen, wird selbstverständlich angewendet und ist in klassischen Prozessdokumentationen nur teilweise festgehalten.
Spätestens bei einem Personalwechsel, einer Vertretung oder der Einarbeitung neuer Mitarbeitender wird deutlich, wie wertvoll dieses Wissen ist.
Die entscheidende Frage lautet deshalb: Wie wird aus persönlicher Erfahrung dauerhaft nutzbares Unternehmenswissen?
Wissen erfassen: Ein KI-Agent stellt die richtigen Fragen
Wer eine Aufgabe seit Jahren erledigt, denkt beim Erklären oft nicht an jedes Detail. Einzelne Prüfschritte, Entscheidungen oder Ausnahmen erscheinen selbstverständlich, obwohl genau diese Informationen für andere besonders wichtig sind.
Unsere Wissensplattform für Expertenwissen setzt deshalb auf geführte Interviews.
Ein KI-Agent begleitet Fachleute durch ein strukturiertes Gespräch – wahlweise per Sprache oder Text. Eine passende Interviewvorlage gibt den thematischen Rahmen vor. Der Agent fragt gezielt nach, wenn Informationen fehlen, und bereitet die Aussagen strukturiert auf.
Ein Beispiel aus dem Monatsabschluss:
Was passiert, wenn eine Buchung erst nach dem vereinbarten Stichtag eingeht?
Aus der ersten Antwort können weitere Fragen entstehen:
- Wer entscheidet über das weitere Vorgehen?
- Welche Fristen müssen berücksichtigt werden?
- Wie wird die Entscheidung dokumentiert?
- Welche Ausnahmen sind aus der Praxis bekannt?
So werden nicht nur einzelne Prozessschritte erfasst, sondern auch Hintergründe, Zuständigkeiten und Erfahrungswerte, die in klassischen Dokumentationen häufig fehlen.
Die Fachleute teilen ihr Wissen im Gespräch. Die KI unterstützt dabei, es vollständig und nachvollziehbar festzuhalten.
Fachlich geprüft: Die Verantwortung bleibt beim Menschen
Aus dem Interview erstellt die Plattform zunächst einen strukturierten Wissensentwurf. Die Inhalte werden in übersichtlichen Kapiteln zusammengeführt und mit Belegen aus dem ursprünglichen Gespräch verknüpft.
Anschließend übernehmen die zuständigen Fachleute die fachliche Prüfung.
Sie kontrollieren die Aussagen auf Richtigkeit, Vollständigkeit und Verständlichkeit, nehmen bei Bedarf Ergänzungen oder Korrekturen vor und geben die Inhalte ausdrücklich frei.
Gleichzeitig lässt sich festlegen, welche Personen auf das Wissen zugreifen dürfen.
Die KI unterstützt bei der Erfassung und Aufbereitung. Die fachliche Verantwortung bleibt beim Menschen.
Durch die Verknüpfung mit den ursprünglichen Gesprächsaussagen lässt sich zudem nachvollziehen, woher eine Information stammt.
Wissen finden und direkt im Arbeitsalltag nutzen
Nach der Freigabe steht das Wissen den berechtigten Mitarbeitenden zur Verfügung.
Über die integrierte Wissenssuche können sie Fragen in natürlicher Sprache stellen, zum Beispiel:
„Was muss ich beachten, wenn eine Buchung nach dem vereinbarten Stichtag eingeht?“
Die Plattform beantwortet die Frage auf Basis der freigegebenen Inhalte. Quellenverweise ermöglichen es, die zugrunde liegenden Informationen und bei Bedarf die entsprechende Stelle im ursprünglichen Interview aufzurufen.
Damit wird dokumentiertes Expertenwissen zu einer Wissensquelle, die Mitarbeitende bei konkreten Aufgaben unterstützt.
Integration in bestehende KI-Anwendungen
Über die MCP-Schnittstelle lässt sich die Wissensbasis außerdem mit MCP-fähigen KI-Anwendungen und -Agenten verbinden.
Dazu zählen beispielsweise ChatGPT, Claude, Microsoft Copilot und Langdock sowie weitere kompatible Lösungen.
Das erfasste und freigegebene Wissen kann dadurch direkt in bereits genutzten KI-Tools bereitgestellt und für Antworten oder Aufgaben verwendet werden.
So wird Expertenwissen nicht nur zentral dokumentiert, sondern lässt sich auch in bestehende digitale Arbeitsabläufe integrieren.
Vom Onboarding bis zur Prozessübergabe: Vielfältige Einsatzmöglichkeiten
Die Wissensplattform eignet sich überall dort, wo Erfahrungswissen für die tägliche Arbeit eine wichtige Rolle spielt.
- Onboarding: Neue Mitarbeitende erhalten Zugang zu bewährten Arbeitsweisen, Prozesshintergründen und typischen Stolperstellen.
- Übergaben und Vertretungen: Aufgaben, Zuständigkeiten und Besonderheiten bleiben auch bei personellen Veränderungen nachvollziehbar.
- Prozesswissen und Ausnahmen: Teams dokumentieren nicht nur Standardabläufe, sondern auch den Umgang mit Sonderfällen.
- Wissenstransfer vor dem Ruhestand: Langjährig aufgebaute Erfahrung wird frühzeitig erfasst und für nachfolgende Kolleginnen und Kollegen verfügbar gemacht.
Für den Einstieg braucht es kein unternehmensweites Wissensprojekt.
Ein klar abgegrenzter Prozess, zu dem regelmäßig Fragen entstehen, und die Erfahrung der zuständigen Fachleute bilden bereits eine sinnvolle Grundlage.
Erlebe die Wissensplattform in einer persönlichen Demo
Wie wird aus einem Gespräch mit erfahrenen Mitarbeitenden eine strukturierte und durchsuchbare Wissensbasis?
In einer persönlichen Demo zeigen wir Dir den gesamten Ablauf: vom KI-gestützten Interview über die fachliche Prüfung und Freigabe bis zur Wissenssuche und Integration in bestehende KI-Anwendungen.
Gemeinsam besprechen wir, welche Einsatzmöglichkeiten für Dein Unternehmen besonders interessant sind.
Du möchtest Expertenwissen sichern und langfristig nutzbar machen?
Dann vereinbare eine persönliche Demo mit uns.
Kontakt: alessandro.cibin@evaco.de
Quelle:
[1] Statistisches Bundesamt (Destatis): „13,3 Millionen Erwerbspersonen erreichen in den nächsten 15 Jahren das gesetzliche Rentenalter“, Pressemitteilung Nr. N039 vom 23. Juni 2026.
https://www.destatis.de/DE/Presse/Pressemitteilungen/2026/06/PD26_N039_13.html
TEILEN
23. Oktober 2026
Mark Leifeld ist neuer Qlik Partner Ambassador
EVACO stellt auch 2026/2027 einen Qlik Partner Ambassador: Mark Philipp Leifeld wurde in das internationale Partner-Ambassador-Programm berufen. Für ihn bedeutet die neue Rolle vor allem eines: Erfahrungen teilen, neue Entwicklungen früh kennenlernen und Impulse aus der Praxis direkt in den Austausch mit Qlik einbringen.
Expertise und Austausch rund um Qlik
Qlik begleitet Mark bereits seit vielen Jahren auf seinem beruflichen Weg. Als Senior Consultant bei EVACO beschäftigt er sich mit einem breiten Spektrum des Qlik Ökosystems – von Analytics-Lösungen und Datenplattformen über Cloud-Migration, Datenintegration und Automatisierung bis hin zu Data Products, Open Lakehouse und dem Qlik AI Portfolio wie Anwers, Predict, etc.
Dabei geht es für Mark um mehr als den Einsatz der Technologie. Neue Funktionen testen, Ideen hinterfragen, Erfahrungen aus der Praxis diskutieren und Wissen in Sessions, Videos und Community-Content weitergeben gehören für ihn genauso dazu. Entscheidend ist, daraus einen konkreten Nutzen für Qlik Kunden und das EVACO Team zu schaffen. Seine quartalsweisen Updates sind für viele Kunden und Kollegen ein Pflichttermin.
Mehr als ein Titel
Dieser persönliche Austausch steht für ihn auch beim Qlik Partner Ambassador Program im Mittelpunkt. Wichtiger als die Repräsentation von Qlik ist ihm der Austausch über Praxiserfahrungen, ein engerer Einblick in Produktstrategie und kommende Funktionen sowie die Möglichkeit, direktes und auch kritisches Feedback einzubringen.
Das entspricht exakt dem Anspruch des Programms: Qlik beschreibt die Interaktion mit anderen Partner Ambassadors und Qlik Product Managern, frühe Schulterblicke in Produktstrategie und Roadmaps sowie die Möglichkeit, Feedback zur Weiterentwicklung der Produkte einzubringen, als zentrale Bestandteile.
Die Erkenntnisse aus diesem internationalen Netzwerk sollen nicht dort bleiben. Mark möchte sie zurück in Kundenprojekte, interne Sessions und die Qlik Community tragen.
Staffelstabübergabe innerhalb von EVACO
Mit Marks Ernennung setzt EVACO seine Beteiligung am Qlik Partner Ambassador Program fort. Simon Schellartz wurde bereits 2023 zum Qlik Partner Ambassador ernannt und stand in dieser Rolle im engen Austausch mit Qlik Produktmanagement und Fachleuten aus dem Qlik Umfeld.
Für Mark hat diese Staffelstabübergabe auch eine persönliche Bedeutung: Simon war während seiner ersten Jahre bei EVACO sein Team Lead. In seinem eigenen Beitrag beschreibt Mark, wie Simon ihm früh Verantwortung übertrug, ihm die Möglichkeit gab, tief in Qlik einzusteigen, und seinen Weg in das Qlik Ökosystem wesentlich mitgeprägt hat.
Nun führt Mark diesen Weg in einer neuen Rolle fort.
Wir gratulieren Mark zur Ernennung und freuen uns auf neue Perspektiven, kritischen Austausch und viele Impulse aus dem internationalen Qlik Netzwerk.
Call-to-Action
Du möchtest mehr über Qlik erfahren oder wissen, wie wir dich bei deinen Data-, Analytics- und AI-Projekten unterstützen können?
TEILEN
23. Oktober 2026
KI Usecase des Monats: Wie KI sensible Daten schützt
Cell Key – Wenn aggregiert nicht automatisch anonym bedeutet
Schutz, ohne die Analyse unnötig einzuschränken
Was auch Teil der Wahrheit ist
Der richtige Einstieg
TEILEN
Qlik Agentic Data Engineering
Datenarbeit neu gedacht Daten für Analytics und AI bereitzustellen, kostet...
TEILEN
AI Use Case Vertragsmanagement
Wenn der Vertragsordner mehr weiß als das Unternehmen Verträge regeln...
TEILEN
Open Knowledge Format
Wenn KI nicht mehr suchen muss, sondern nachschlagen kann KI-Modelle...
TEILEN
Lokale LLMs: Mehr Kontrolle, weniger Abhängigkeit
Fable/Mythos zeigt: KI braucht Datensouveränität Large Language Models fassen Verträge...
TEILEN
19. August 2026
Qlik Agentic Data Engineering
Datenarbeit neu gedacht
Daten für Analytics und AI bereitzustellen, kostet in vielen Unternehmen sehr viel Zeit und manuellen Aufwand. Mit Qlik Agentic Data Engineering erweitert Qlik seine Plattform um spezialisierte AI Agents, die Data Teams bei zentralen Aufgaben unterstützen – von Datenqualität und Katalogisierung bis hin zur Entwicklung von Datenpipelines.
Als Qlik Partner der ersten Stunde begleitet EVACO Unternehmen dabei, Technologie und Datenstrategie sinnvoll zu integrieren und aus neuen Funktionen konkrete Mehrwerte für den Arbeitsalltag zu schaffen. Wir erachten Qlik Agentic Data Engineering als Chance, einen Technologiesprung auf Basis bestehender Tools und Strukturen zu erzielen und unmittelbare Mehrwerte zu generieren.
Mehr Unterstützung im Data Engineering
Mit Agentic AI verändert sich auch die Arbeit im Data Engineering. Wiederkehrende Aufgaben müssen nicht mehr ausschließlich manuell umgesetzt werden. Spezialisierte Agents können einzelne Arbeitsschritte übernehmen und Data Engineers gezielt unterstützen.
Qlik verbindet diesen Ansatz mit Funktionen rund um Datenintegration, Datenqualität, Governance und Datenprodukte. So entsteht eine durchgängige Grundlage, um Daten verlässlich für Analytics- und AI-Anwendungen bereitzustellen.
Konkret bedeutet das für Dich: weniger Zeit für repetitive Aufgaben und mehr Raum für Architektur, Governance und die Weiterentwicklung Deiner Datenplattform.
Spezialisierte Agents für unterschiedliche Aufgaben
Qlik stellt in Qlik Talend Cloud verschiedene Agents für konkrete Aufgaben entlang des Datenlebenszyklus bereit:
- Der Data Product Agent unterstützt Dich bei der Erstellung, Governance und Bereitstellung kuratierter Datenprodukte.
- Der Data Quality Agent hilft Dir dabei, Daten zu profilieren, ihre Qualität zu überwachen und Probleme frühzeitig zu erkennen.
- Der Catalog and Business Glossary Agent unterstützt bei der Klassifizierung und Dokumentation von Daten sowie bei der Pflege einheitlicher Geschäftsbegriffe.
- Der Pipeline Agent ist darauf ausgelegt, den Aufbau und die Bereitstellung von Datenpipelines stärker zu automatisieren.
Damit geht Qlik über klassische AI-Assistenten hinaus. Die einzelnen Agents sind auf konkrete Aufgabenbereiche ausgerichtet und unterstützen Dich innerhalb definierter Rahmenbedingungen.
Datenpipelines in natürlicher Sprache beschreiben
Ein weiterer Bestandteil von Qlik Agentic Data Engineering sind die sogenannten Declarative Data Pipelines.
Dabei beschreibst Du das gewünschte Ergebnis einer Datenpipeline in natürlicher Sprache. Coding Agents unterstützen anschließend bei der technischen Umsetzung. Qlik nennt hier unter anderem Claude Code und GitHub Copilot in Verbindung mit Visual Studio Code.
Der Fokus verschiebt sich damit vom einzelnen technischen Schritt stärker auf das gewünschte Ergebnis. Governance und Datenqualität bleiben dabei ein fester Bestandteil des Prozesses.
Achilles-Ferse im Griff: verlässliche Datenbasis
Agentic AI kann nur dann sinnvoll arbeiten, wenn auch die zugrunde liegenden Daten stimmen. Und je eigenständiger AI-Systeme Aufgaben übernehmen, desto wichtiger werden Datenqualität, nachvollziehbare Herkunft, einheitlicher Kontext und klare Governance. Genau hier setzt Qlik mit Agentic Data Engineering an.
Es geht also nicht allein um mehr Automatisierung. Entscheidend ist eine Datenbasis, auf die sich Menschen, Anwendungen und AI Agents gleichermaßen verlassen können.
Was bedeutet das für Dein Data Team?
Besonders interessant wird Agentic Data Engineering dort, wo heute viel Zeit in wiederkehrende Aufgaben fließt: Datenprofiling, Qualitätsprüfungen, Katalogisierung, Dokumentation oder die Pflege von Pipelines.
Qlik setzt Agents genau an diesen Punkten ein. So kannst Du Routineaufgaben stärker automatisieren und Deine Ressourcen dort einsetzen, wo sie den größeren Mehrwert schaffen – etwa bei Datenarchitektur, Governance oder der Entwicklung neuer Use Cases.
Von der Technologie zum passenden Einsatz
Neue Funktionen allein schaffen noch keinen Mehrwert. Entscheidend ist, wie gut sie zu Deiner Datenarchitektur, Deinen Prozessen und Deinen Zielen passen. Hier unterstützen wir Dich gerne: wir kennen die Qlik Plattform aus zahlreichen Projekten und unterschiedlichen Anwendungsszenarien aus dem Effeff und helfen Dir, die Möglichkeiten von Qlik Agentic Data Engineering einzuordnen, passende Einsatzfelder zu identifizieren und sie sinnvoll und minimalinvasiv in Deine bestehende Umgebung zu integrieren.
Gemeinsam mit Dir klären wir, welche Prozesse sich für eine stärkere Automatisierung eignen, welche Anforderungen an Datenqualität und Governance bestehen und wie sich eine verlässliche Grundlage für Analytics und AI schaffen lässt.
Qlik Agentic Data Engineering mit EVACO – wir unterstützen Dich von der ersten Einordnung bis zur Umsetzung in Deiner bestehenden Qlik Umgebung.
TEILEN
19. August 2026
AI Use Case Vertragsmanagement
Wenn der Vertragsordner mehr weiß als das Unternehmen
Verträge regeln einen erheblichen Teil des unternehmerischen Alltags: Kunden- und Lieferantenbeziehungen, Miete und Leasing, Wartung, Software-Lizenzen, Versicherungen, Arbeitsverhältnisse. So verbindlich ihre Inhalte sind, so unübersichtlich ist häufig ihre Ablage: Der Bestand verteilt sich auf Aktenordner, Netzlaufwerke, Postfächer und Fachsysteme – als Papier, Scan oder PDF und nicht selten in unterschiedlichen Versionen.
Das eigentliche Problem ist deshalb meist nicht, dass Informationen fehlen. Sie sind vorhanden – aber nicht verfügbar. Was vereinbart wurde, weiß im Zweifel nur, wer den Vertrag gelesen hat. Spürbar wird das spätestens, wenn eine Kündigungsfrist näher rückt, vor einem Audit bestimmte Klauseln gefunden werden müssen oder in einer Verhandlung kurzfristig zu klären ist, welche Konditionen eigentlich gelten. Dass daraus reale Kosten entstehen, ist gut belegt: World Commerce & Contracting beziffert den durchschnittlichen Wertverlust durch schwaches Vertragsmanagement auf rund neun Prozent des Jahresumsatzes – die besten Unternehmen halten ihn bei etwa drei Prozent, die schwächsten verlieren 15 Prozent und mehr. [1]
Was KI bei der Vertragsanalyse leisten kann
Genau hier setzt KI-gestützte Vertragsanalyse an. Dokumente werden digital erfasst und automatisiert analysiert; bei gescannten Verträgen übernehmen Texterkennung oder multimodale Modelle das Lesen, ein Sprachmodell arbeitet die relevanten Angaben anschließend strukturiert heraus: Vertragsparteien und -gegenstand, Laufzeiten, Kündigungsfristen und Verlängerungsregelungen, Zahlungsbedingungen und Preisanpassungsklauseln, Haftungs- und Gewährleistungsregelungen, Sonderkündigungsrechte sowie Vereinbarungen zu Datenschutz und Vertraulichkeit.
Entscheidend ist dabei die Nachvollziehbarkeit: Jede extrahierte Angabe bleibt mit ihrer Fundstelle im Originaldokument verknüpft, sodass sich jederzeit prüfen lässt, worauf sich eine Aussage stützt.
Aus dem verteilten Bestand entsteht so Schritt für Schritt ein strukturiertes Vertragsregister: Fristen werden sichtbar, Klauseln vergleichbar, Vertragsinformationen auswertbar. Fragen, deren Beantwortung bislang tagelange Sichtung bedeutete, lassen sich in Minuten klären: Welche Verträge verlängern sich in den kommenden 90 Tagen automatisch? Wo fehlt eine Regelung zur Informationssicherheit? Welche Lieferantenverträge enthalten Preisanpassungsklauseln? Und weil die Ergebnisse strukturiert vorliegen, lassen sie sich in bestehende Analytics-Umgebungen wie Qlik oder Power BI übernehmen – Vertragsinformationen werden damit nicht nur auffindbar, sondern Teil des operativen Controllings.
Von der Extraktion zur intelligenten Prüfung
Besonders interessant wird der Anwendungsfall dort, wo Verträge nicht nur ausgelesen, sondern miteinander oder mit definierten Standards verglichen werden. Ein System erkennt dann, ob eine geforderte Klausel vorhanden ist, ob eine Formulierung von der eigenen Standardvorlage abweicht oder ob vereinbarte Konditionen außerhalb definierter Grenzen liegen. Damit verschiebt sich der Nutzen von der reinen Suche zur systematischen Vorprüfung: Die KI markiert Auffälligkeiten, macht Unterschiede sichtbar und priorisiert relevante Passagen – und entlastet Fachbereiche und juristische Expertinnen und Experten spürbar bei der Sichtung. Was sie nicht liefert, ist ein verbindliches juristisches Urteil.
Warum gerade hier lokale Verarbeitung überzeugt
Kaum ein Datenbestand ist so vertraulich wie der Vertragsbestand: Preise und Konditionen, Verhandlungsergebnisse, Haftungsregelungen, strategische Geschäftsbeziehungen – und spätestens bei Arbeitsverträgen hochsensible personenbezogene Daten. Oft verpflichtet schon der Vertrag selbst zur Geheimhaltung gegenüber Dritten. Cloud-Dienste zur Vertragsanalyse gibt es viele, und wenn Datenschutz, Vertragsbedingungen und Architektur zu den eigenen Anforderungen passen, können sie eine tragfähige Option sein. Gerade bei Kernverträgen, Konditionen und Personalunterlagen stellt sich jedoch eine weitergehende Frage: Müssen diese Dokumente die eigene, kontrollierte Infrastruktur überhaupt verlassen?
Genau hier spielt eine lokale Architektur ihre Stärken aus: Dokumentenverarbeitung, Sprachmodell, Suchindex und Ablage laufen vollständig auf der eigenen Infrastruktur – weder die Verträge noch die daraus gewonnenen Informationen werden zur Verarbeitung an externe KI-Dienste übertragen. Leistungsfähige offene Modelle machen das heute realistisch. Entscheidend ist allerdings die gesamte Kette: Ein lokal betriebenes Sprachmodell allein schafft noch keine Datensouveränität – auch Texterkennung, Embeddings, Suchindex, Protokollierung, Zwischenergebnisse und Backups gehören ins Sicherheitskonzept.
Das Gleiche gilt für Berechtigungen: Nicht jede Person, die nach Verträgen suchen darf, sollte automatisch jeden Vertrag sehen können. Zugriffsrechte müssen deshalb auch innerhalb der KI-Anwendung durchgesetzt werden – Personalunterlagen bleiben beim zuständigen Personenkreis, sensible Einkaufskonditionen bei den berechtigten Bereichen. Hinzu kommt die Anpassbarkeit: eigene Vertragsarten, definierte Klauselkataloge, der Abgleich mit den eigenen Standardformulierungen und auf Wunsch die Übergabe erkannter Fristen an bestehende Systeme.
Was auch Teil der Wahrheit ist
Ein realistischer Blick gehört dazu. KI-gestützte Vertragsanalyse extrahiert, strukturiert, vergleicht und weist auf Auffälligkeiten hin – sie ersetzt keine juristische Prüfung und keine Rechtsberatung. Ob eine Klausel rechtlich wirksam, wirtschaftlich akzeptabel oder im konkreten Kontext riskant ist, bleibt eine fachliche Bewertung; das Ergebnis der KI ist ein sehr guter Arbeitsstand, keine freigegebene Entscheidung. Auch die Qualität der Dokumente setzt Grenzen: Schlechte Scans, handschriftliche Ergänzungen und verstreute Nachträge verarbeitet die Technik heute erstaunlich gut, aber nicht fehlerfrei – Fundstellenverweise, Qualitätskontrollen und Stichproben sind deshalb Pflicht. Und schließlich verhindert eine erkannte Frist allein noch keine verpasste Kündigung: Es braucht einen gelebten Prozess mit Verantwortlichkeiten, Erinnerungen und klaren Entscheidungen. Sonst entsteht aus einer unübersichtlichen Vertragsablage lediglich eine übersichtlichere Vertragsablage.
Der richtige Einstieg
Für den Start muss nicht der gesamte Bestand erschlossen werden. Bewährt hat sich ein klar abgegrenzter Anwendungsfall: eine Vertragsart – etwa Lieferanten-, Wartungs- oder Mietverträge –, ein Pilotbereich und ein definierter Satz an Informationen und Klauseln, die tatsächlich gebraucht werden. An diesem Bestand zeigt sich, wie zuverlässig die Dokumente verarbeitet werden, welche Angaben sich automatisiert extrahieren lassen und wo weiterhin menschliche Prüfung nötig ist. Darauf aufbauend lässt sich fundiert entscheiden, wie die Lösung ausgebaut und in bestehende Prozesse integriert wird – bis hin zum Baustein einer eigenen lokalen KI-Plattform, auf deren Dokumenten-, Retrieval- und Berechtigungsarchitektur weitere Anwendungsfälle aufsetzen.
Die Anforderungen dafür lassen sich am besten in gezielten Workshops und anhand konkreter Dokumente erarbeiten: Welche Vertragsarten stehen im Fokus? Welche Informationen und Klauseln werden benötigt? Welche Systeme sind anzubinden, welche Berechtigungen gelten? Welche Vorgaben bestehen für Datenschutz, Aufbewahrung und Informationssicherheit – und an welchen Stellen muss ein Mensch eine Entscheidung bestätigen? Daraus entsteht keine theoretische KI-Vision, sondern eine belastbare Grundlage für Architektur, Pilotierung und Investitionsentscheidung.
Genau hier setzt EVACO an: von der strategischen Einordnung über konkrete Workshops bis zur Konzeption und Umsetzung passender KI-Lösungen. Gern beraten wir Dich unverbindlich, wie sich Dein Vertragsbestand sicher erschließen, strukturiert auswerten und in bestehende Prozesse integrieren lässt. Du erreichst mich unter alessandro.cibin@evaco.de.
Quellen
[1] World Commerce & Contracting (WorldCC): Contract Management Whitepaper, August 2025 – https://info.worldcc.com/contract-management-aug-2025
TEILEN
15. Juli 2026
Open Knowledge Format
Wenn KI nicht mehr suchen muss, sondern nachschlagen kann
KI-Modelle werden von Generation zu Generation leistungsfähiger. Über die Qualität ihrer Ergebnisse entscheidet im Unternehmenseinsatz trotzdem selten das Modell allein, sondern der Kontext, den es erhält: Was bedeutet die Kennzahl „aktiver Kunde“ bei uns? Welche Tabelle ist die verbindliche Quelle? Wer ist verantwortlich, wenn ein Prozess nicht funktioniert?
Die Antworten existieren in den meisten Unternehmen – verteilt auf Wikis, Laufwerke, Datenkataloge, Ticketsysteme und die Köpfe erfahrener Kolleginnen und Kollegen. Jedes neue KI-Projekt beginnt deshalb damit, denselben Kontext erneut zusammenzusuchen und aufzubereiten. Das eigentliche Problem ist häufig nicht fehlendes Wissen, sondern fehlende Kontext-Infrastruktur.
Genau hier setzt das Open Knowledge Format (OKF) an, das Google Cloud am 12. Juni 2026 als offene, herstellerneutrale Spezifikation vorgestellt hat – aktuell in Version 0.1 und ausdrücklich als Ausgangspunkt gedacht. [1] Die Idee: Unternehmenswissen wird so beschrieben, dass es an keine Plattform, keine Datenbank und kein bestimmtes KI-Modell gebunden ist. Modelle können wechseln. Das Wissen, auf das sie zugreifen, bleibt.
Zur Einordnung: So funktioniert klassisches RAG
Wer heute einen KI-Assistenten mit eigenen Informationen versorgt, setzt meist auf Retrieval-Augmented Generation (RAG): Dokumente werden in Abschnitte zerlegt und indexiert; zu jeder Frage ermittelt das System die relevantesten Textstellen und übergibt sie dem Sprachmodell als Kontext. [3] Der große Vorteil ist der schnelle Einstieg – die Dokumente bleiben, wie sie sind. Gerade für umfangreiche, unstrukturierte Bestände ist RAG deshalb zu Recht etabliert.
Zugleich entscheidet die Qualität der Suche, was das Modell überhaupt zu sehen bekommt. Gefundene Textstellen kommen ohne Zusammenhang; bei widersprüchlichen Dokumenten bleibt offen, welche Definition verbindlich ist; und verfehlt das Retrieval die passende Quelle, entstehen sprachlich überzeugende, aber fachlich falsche Antworten. Zugespitzt: RAG findet Belege. Welche Aussage im Unternehmen gilt, entscheidet es nicht – das ist eine Frage von Governance, nicht von semantischer Ähnlichkeit.
Was das Open Knowledge Format anders macht
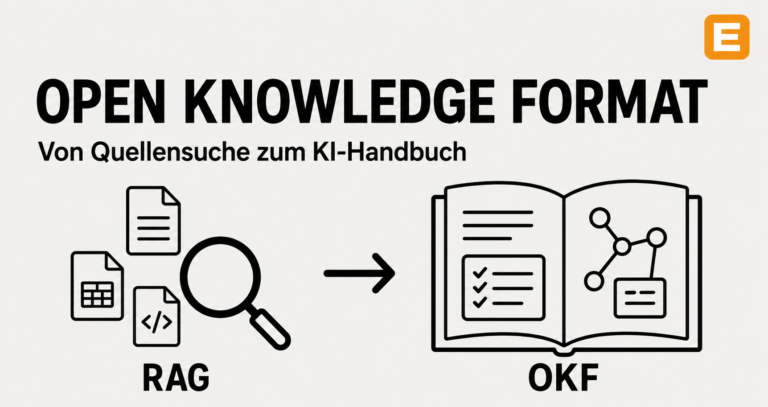
OKF beginnt nicht bei der Suche, sondern bei der Repräsentation des Wissens. Ein OKF-„Bundle“ ist ein Verzeichnis einfacher Markdown-Dateien. Jede Datei beschreibt genau ein Konzept – eine Tabelle, eine Kennzahl, eine Schnittstelle, einen Prozess. Am Anfang steht ein kleiner strukturierter Kopfbereich im YAML-Format, in dem nur das Feld type verpflichtend ist; darunter folgt normaler Text mit Definitionen, Schemata und Zuständigkeiten. Gewöhnliche Markdown-Links verbinden die Konzepte zu einem Wissensnetz, eine Index-Datei dient als Einstiegspunkt. [1]
Für einen KI-Agenten ähnelt das einem gut gepflegten Betriebshandbuch: Er rekonstruiert nicht bei jeder Frage neu, was ein Begriff wahrscheinlich bedeutet, sondern öffnet eine geprüfte Konzeptseite und folgt ihren Verweisen. Ganz ohne Suche kommt auch er nicht aus – aber er sucht in konsolidiertem Wissen statt in Rohdokumenten.
Drei Eigenschaften machen den Ansatz interessant: Dieselbe Datei ist für Menschen lesbar und für Agenten verarbeitbar – ohne Übersetzungsschicht. Wissen lässt sich wie Code verwalten, mit Versionierung und nachvollziehbaren Reviews statt stiller Wiki-Edits. Und OKF ist Format statt Plattform: kein Konto, kein SDK, keine Bindung an Anbieter oder Werkzeuge. [1]
RAG oder OKF? Beides.
Der Kernunterschied liegt im Ausgangsmaterial. RAG erschließt vorhandene Rohdokumente und leitet Wissen bei jeder Anfrage neu ab – mit geringem Startaufwand, aber abhängig von Dokumenten- und Suchqualität. OKF hält kuratierte Konzeptseiten bereit – konsistent und wiederverwendbar; dafür muss das Wissen einmal explizit gemacht und dauerhaft gepflegt werden, sonst wird es zum dokumentierten Irrtum. Und während RAG mit breitem Tooling etabliert ist, steht OKF als junge Spezifikation noch am Anfang.
RAG liefert Reichweite. OKF liefert Orientierung.
In der Praxis ergänzen sich beide: OKF für das Kernwissen, bei dem Konsistenz zählt – Kennzahlendefinitionen, Datenmodelle, Schnittstellen, zentrale Prozesse. RAG für die Masse an Dokumenten, die niemand kuratieren wird – Verträge, Protokolle, Berichte, E-Mails. Ein gepflegtes Bundle ist zudem selbst hervorragendes Ausgangsmaterial für ein RAG-System.
Interessant ist auch der Impuls hinter OKF: das von Andrej Karpathy beschriebene „LLM Wiki“-Muster, bei dem ein Sprachmodell eine dauerhafte, verlinkte Wissensbasis pflegt – neue Quellen einarbeitet, Querverweise ergänzt, Widersprüche sichtbar macht. [2] Agenten können so einen Großteil der Pflegearbeit übernehmen. Welche Definition gilt und welche Änderung freigegeben wird, bleibt jedoch eine Governance-Aufgabe: OKF garantiert weder die Richtigkeit einer Aussage, noch regelt es Berechtigungen oder Infrastruktur.
Worauf es beim Einstieg ankommt
Ein Format allein schafft noch keinen verlässlichen Wissensbestand. Bewährt hat sich ein pragmatischer Start: mit einem klar abgegrenzten Bereich beginnen, etwa den zwanzig wichtigsten Kennzahlen eines Fachbereichs; je Konzept klären, welche Quelle maßgeblich ist und wer fachlich verantwortet; automatisch erzeugen, wo es sinnvoll ist, und von Fachleuten prüfen lassen; Reviews von Anfang an einplanen. Vor allem aber ist die Pflege eine Daueraufgabe, kein Projekt mit Enddatum.
Wissen einmal strukturieren, überall nutzen
Die eigentliche Chance liegt nicht darin, dass KI-Modelle grundsätzlich intelligenter werden – sondern darin, dass Unternehmen ihren Kontext nicht für jede neue Anwendung erneut aufbereiten müssen. Liegen zentrale Definitionen und Zusammenhänge einmal portabel und maschinenlesbar vor, profitieren alle Anwendungen davon: der Assistent im Fachbereich, der Agent in der Datenanalyse, das nächste Automatisierungsvorhaben. Das Wissen wird vom projektspezifischen Hilfsmittel zu einem Teil der Infrastruktur.
Oder ganz kurz: RAG durchsucht die Quellen. OKF pflegt das Handbuch.
Du möchtest herausfinden, ob das Open Knowledge Format ein sinnvoller Baustein für Eure KI-Vorhaben ist – oder wie sich OKF und RAG in Eurer Umgebung kombinieren lassen? Sprich uns gerne an, Du erreichst mich unter alessandro.cibin@evaco.de. Wir unterstützen Euch bei der Einordnung, beim Aufbau eines ersten Wissens-Bundles und bei der Integration in bestehende KI-Anwendungen.
Quellen
[1] Google Cloud: „Introducing the Open Knowledge Format“, 12. Juni 2026 – https://cloud.google.com/blog/products/data-analytics/how-the-open-knowledge-format-can-improve-data-sharing · Spezifikation: https://github.com/GoogleCloudPlatform/knowledge-catalog/tree/main/okf
[2] Andrej Karpathy: „LLM Wiki“, 4. April 2026 – https://gist.github.com/karpathy/442a6bf555914893e9891c11519de94f
[3] Patrick Lewis et al.: „Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks“, NeurIPS 2020 – https://arxiv.org/abs/2005.11401
TEILEN
12. Juni 2026
Lokale LLMs: Mehr Kontrolle, weniger Abhängigkeit
Fable/Mythos zeigt: KI braucht Datensouveränität
Large Language Models fassen Verträge zusammen, beantworten Kundenanfragen und durchsuchen Dokumentenberge in Sekunden. Was als Experiment begann, ist in vielen Unternehmen längst Teil des Arbeitsalltags. Mit jeder Anfrage fließen dabei Daten in diese Systeme, und damit rückt eine Frage unweigerlich in den Mittelpunkt: Was geschieht eigentlich mit diesen Daten?
Und nicht nur das: die US-Regierung hat Anthropic am 13.06. per Notanordnung verboten, seine fortschrittlichsten Modelle Fable 5 und Mythos 5 für ausländische Staatsangehörige bereitzustellen. Quintessenz: Es geht nicht nur um Datenschutz!
Wer sich vollständig auf externe KI-Anbieter verlässt, macht sich auch abhängig von politischen Entscheidungen, regulatorischen Vorgaben und Geschäftsinteressen Dritter.
Das kann schnell kritisch werden. Besonders dann, wenn KI-Anwendungen bereits tief in Prozesse, Wissensarbeit oder sicherheitsrelevante Abläufe integriert sind. Die gute Nachricht: Es gibt heute mehr Optionen als noch vor wenigen Jahren – von abgesicherten Cloud-Modellen über hybride Architekturen bis hin zu lokalen LLMs auf eigener Infrastruktur.
Je nach Anbieter, Region und Vertragsmodell kannst Du Daten heute innerhalb der EU verarbeiten lassen, vertraglich gegen eine Nutzung fürs Modelltraining absichern und durch Verschlüsselung sowie fein abgestufte Berechtigungskonzepte schützen. Für viele Unternehmen und Anwendungsfälle sind das tragfähige Optionen.
Manchen reicht das nicht. Wenn Du besonders sensible Informationen verarbeitest, strengen regulatorischen Vorgaben unterliegst oder schlicht maximale Kontrolle behalten willst, möchtest Du einen Schritt weiter gehen: Die Daten sollen die eigene Infrastruktur gar nicht erst verlassen. Für genau diese Fälle sind lokale LLMs eine ernstzunehmende Alternative.
Die Vorteile lokaler Modelle
Der entscheidende Vorteil ist Kontrolle. Bei einer konsequent lokalen Architektur läuft die gesamte Verarbeitung auf Deiner eigenen Infrastruktur. Keine Anfrage und kein vertrauliches Dokument verlässt Dein Unternehmen. Entscheidend ist dabei der Blick auf die ganze Kette: Neben dem Sprachmodell selbst gehören auch Embeddings, Vektordatenbank, Schnittstellen, Logging, Monitoring und gegebenenfalls die Dokumenten- und OCR-Verarbeitung dazu. Erst wenn all diese Komponenten lokal oder kontrolliert betrieben werden, entsteht echte Datensouveränität.
So bleiben Informationen innerhalb Deiner eigenen Systemgrenzen, was Datenschutz, Compliance und die Einhaltung interner Sicherheitsrichtlinien spürbar erleichtert. Im Gegenzug bleibt auch die Verantwortung bei Dir: Berechtigungen, Verschlüsselung, Betrieb und Wartung wollen sauber geplant und umgesetzt sein.
Hinzu kommt Unabhängigkeit. Wenn Du lokal betreibst, hängst Du weder an den Preismodellen noch an den Nutzungsbedingungen oder der Verfügbarkeit einzelner Anbieter. Auch die Kosten verschieben sich: An die Stelle der Abrechnung pro Anfrage treten kalkulierbare Aufwände für Infrastruktur und Betrieb. Das ist nicht zwangsläufig günstiger, aber deutlich planbarer.
Und schließlich: Anpassbarkeit. Lokale Lösungen lassen sich gezielt auf Fachbereiche, Datenbestände und Prozesse zuschneiden, etwa über Retrieval-Augmented Generation, klare Systemvorgaben oder bei Bedarf Fine-Tuning. So entstehen Anwendungen, die nicht generisch auf Sprache reagieren, sondern fest in Deinem Unternehmenskontext verankert sind.
Von der lokalen Lösung zur eigenen KI-Plattform
Auf dieser Basis kannst Du konkrete Anwendungen aufbauen: interne Wissensassistenten, die automatisierte Auswertung großer Dokumentenbestände oder die Anbindung an bestehende Fachsysteme. Strategisch weitergedacht kann daraus eine eigene lokale KI-Plattform werden, die als gemeinsame Grundlage für unterschiedliche Anwendungen in Deinem Unternehmen dient.
Eine Einschränkung gehört ehrlicherweise dazu: Der lokale Betrieb bietet nicht die Flexibilität der Cloud. Schnelles Skalieren, der sofortige Zugriff auf die jeweils neuesten Modelle und das vollständige Auslagern des Betriebs stehen lokal nicht im gleichen Maße zur Verfügung. Umso wichtiger ist es, Deine Anforderungen vorab präzise zu klären: Welche Anwendungsfälle und Daten stehen im Fokus? Welche Modellgröße ist nötig, mit welcher Last ist zu rechnen? Und welche Vorgaben gelten für Sicherheit, Betrieb und Integration in Deine bestehende Systemlandschaft?
Der richtige Einstieg
Genau diese Klarheit lässt sich am besten in gezielten Workshops schaffen, in denen Anforderungen, Anwendungsfälle und technische Rahmenbedingungen gemeinsam herausgearbeitet werden. Das Ergebnis ist die Grundlage für eine belastbare Architekturentscheidung.
Und weil der Aufbau einer lokalen Lösung Zeit und Investitionen bedeutet, lohnt sich oft noch ein Schritt davor: die Auseinandersetzung mit Deiner KI-Strategie. Sie stellt sicher, dass Prioritäten richtig gesetzt werden und die spätere technische Lösung, ob Cloud, lokal oder hybrid, tatsächlich auf Deine Unternehmensziele einzahlt, statt isoliert zu entstehen.
Genau hier setzt EVACO an: von der strategischen Einordnung über konkrete Workshops bis zur Konzeption und Umsetzung passender KI-Lösungen. Gern beraten wir Dich unverbindlich, welcher Ansatz für Dein Unternehmen der richtige ist. Du erreichst uns unter info@evaco.de info@evaco.de.
TEILEN